2026年9月8日 | 事件编号 INC 20260908 01
时间统一为 UTC+8。生产站 f.yourtj.de,关联测试站 [已脱敏]。
报告依据现场命令回显、任务时间戳、云控制台监控及补查的代理日志编制。
执行摘要
生产站出现持续 504,测试站同步响应超时。现场证据确认主机处于严重 I/O 等待状态:2 核系统负载超过 25,CPU 约 95% 时间等待 I/O,PostgreSQL、OpenResty 等进程进入不可中断等待。大量文件页被回收后重新载入,是最有支持的故障机制。
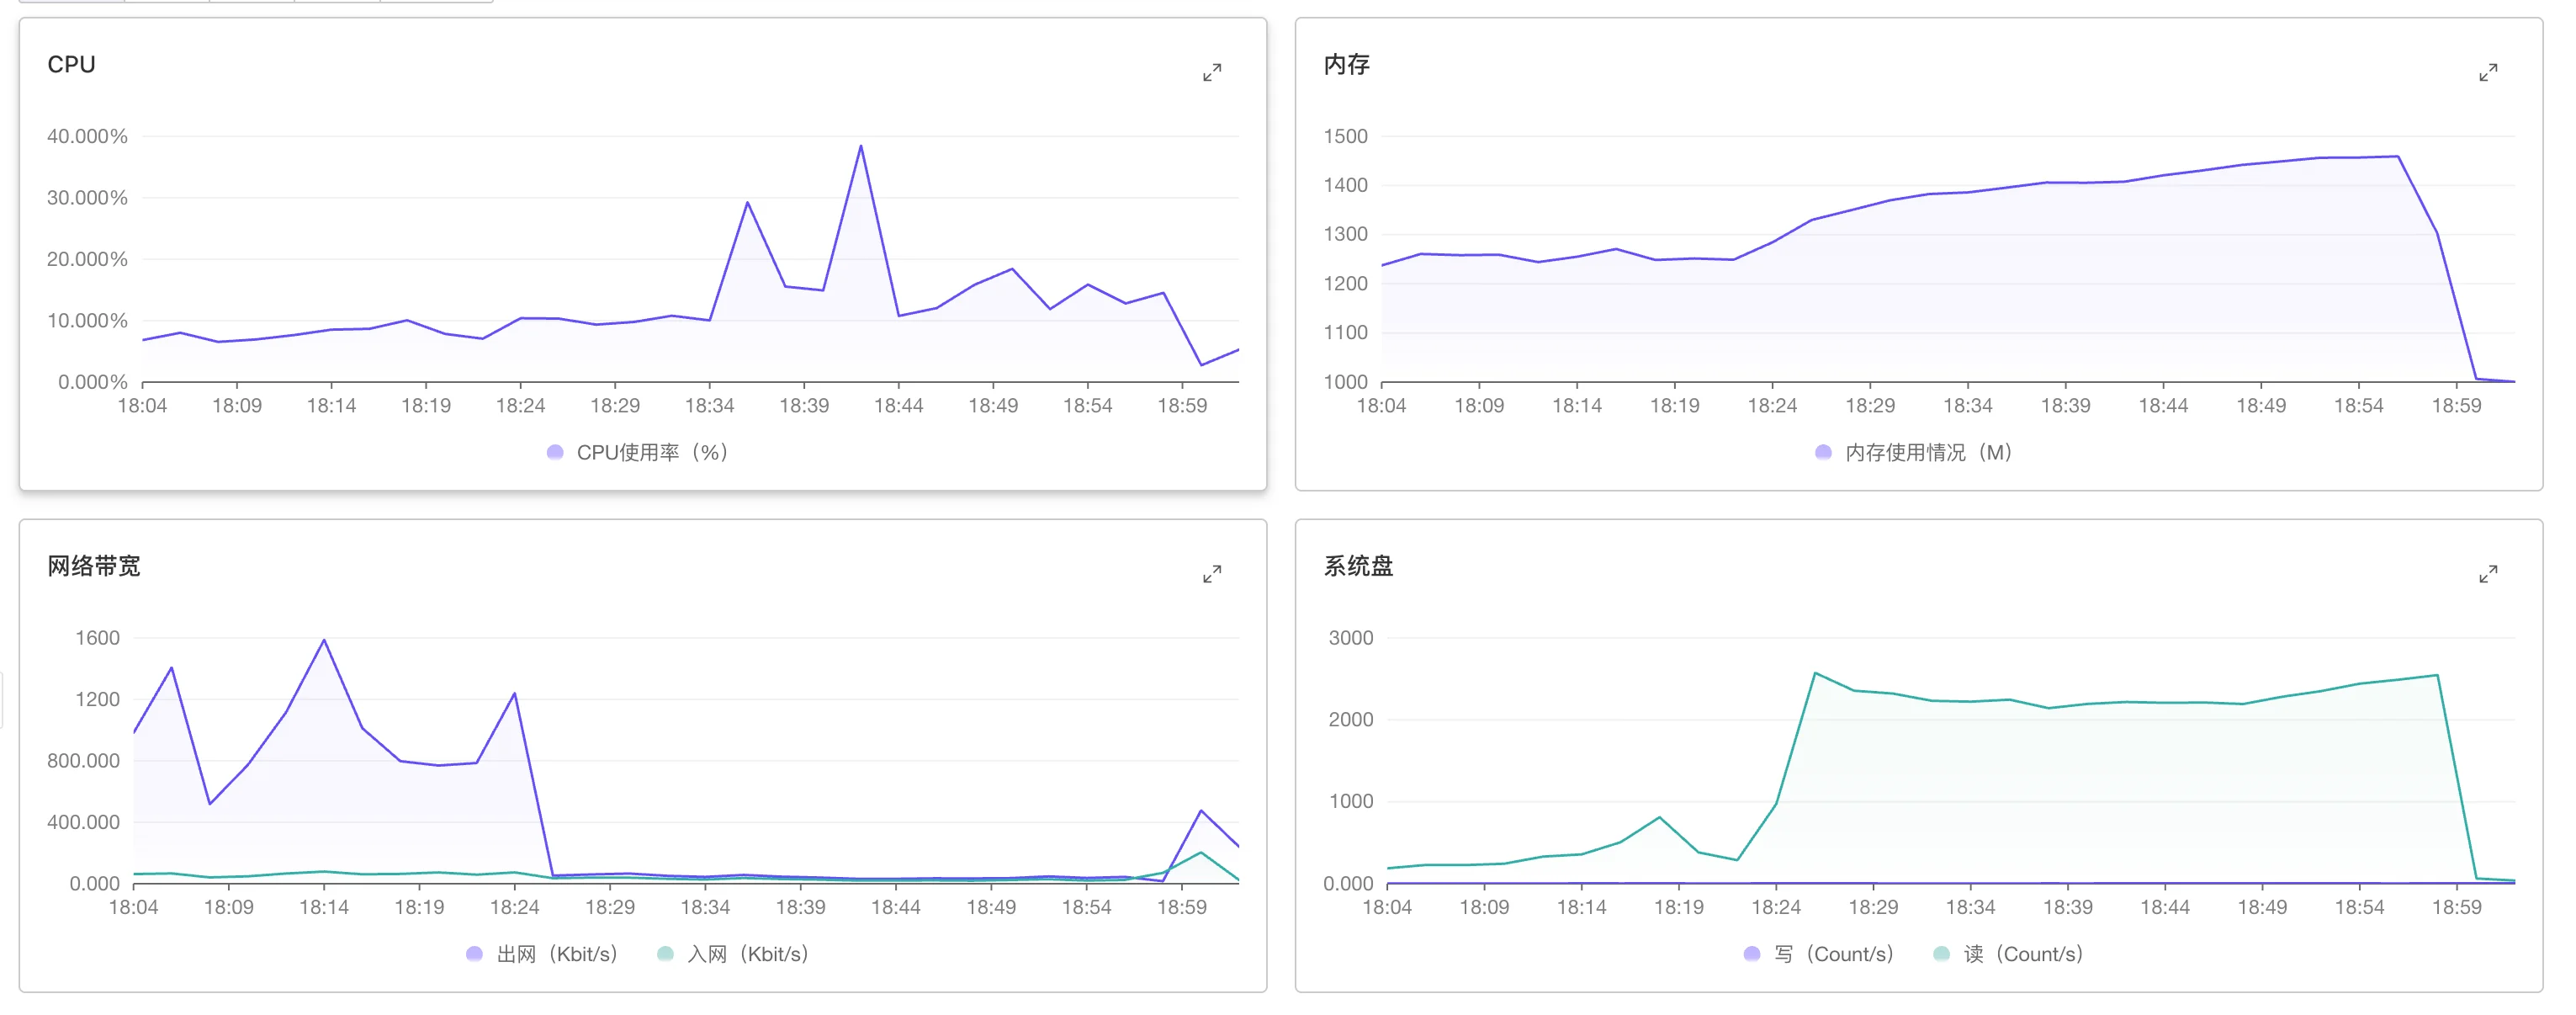
vm.swappiness=0 与 8 MiB 磁盘预读构成重要促发条件,但此次工作集压力的最初触发源尚未查明。重启主机后服务先行恢复,随后完成内存回收与预读参数调整及持久化。当前应归类为服务已恢复、短时验收通过,根因闭环与高峰负载验证仍未完成。
| 日志可见故障窗口 |
排障与处置历时 |
窗口内5xx响应 |
| 33分24秒 |
28分45秒 |
3,216次 |
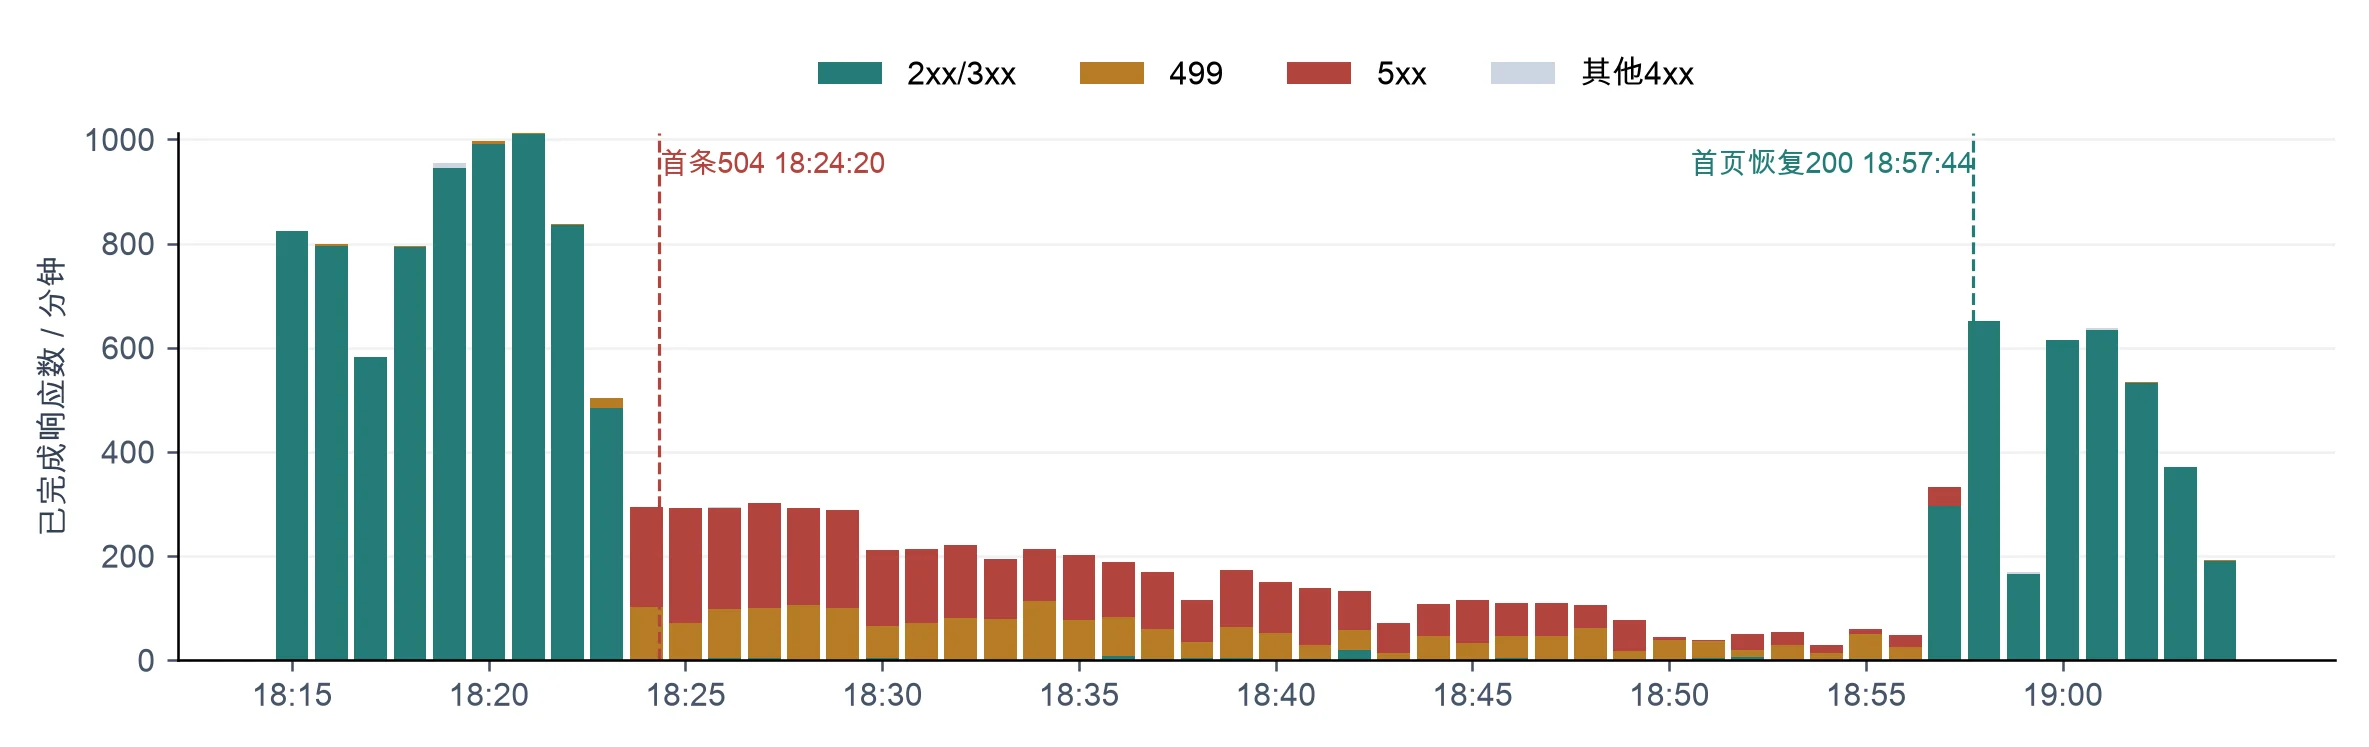
图1 生产站逐分钟响应分布,18:15至19:04。统计的是代理已记录的响应,包含用户、自动流量、重试及探测;低请求数不代表恢复。499表示客户端提前断开。
影响范围
在 [18:24:20, 18:57:44) 内,生产代理记录 5,114 次响应,其中 3,180 次504、35次503、1次502,另有1,805次499。首页与API均受影响。无法由这些请求计数推导独立受影响用户数。
时间口径与处置时间线
故障时长采用固定、可复核的日志口径:生产首条504响应结束时间,到重启后首页首条200响应结束时间。它是日志可见窗口,不是已知精确的异常起始时刻;504通常在等待上游超时后才写入日志。
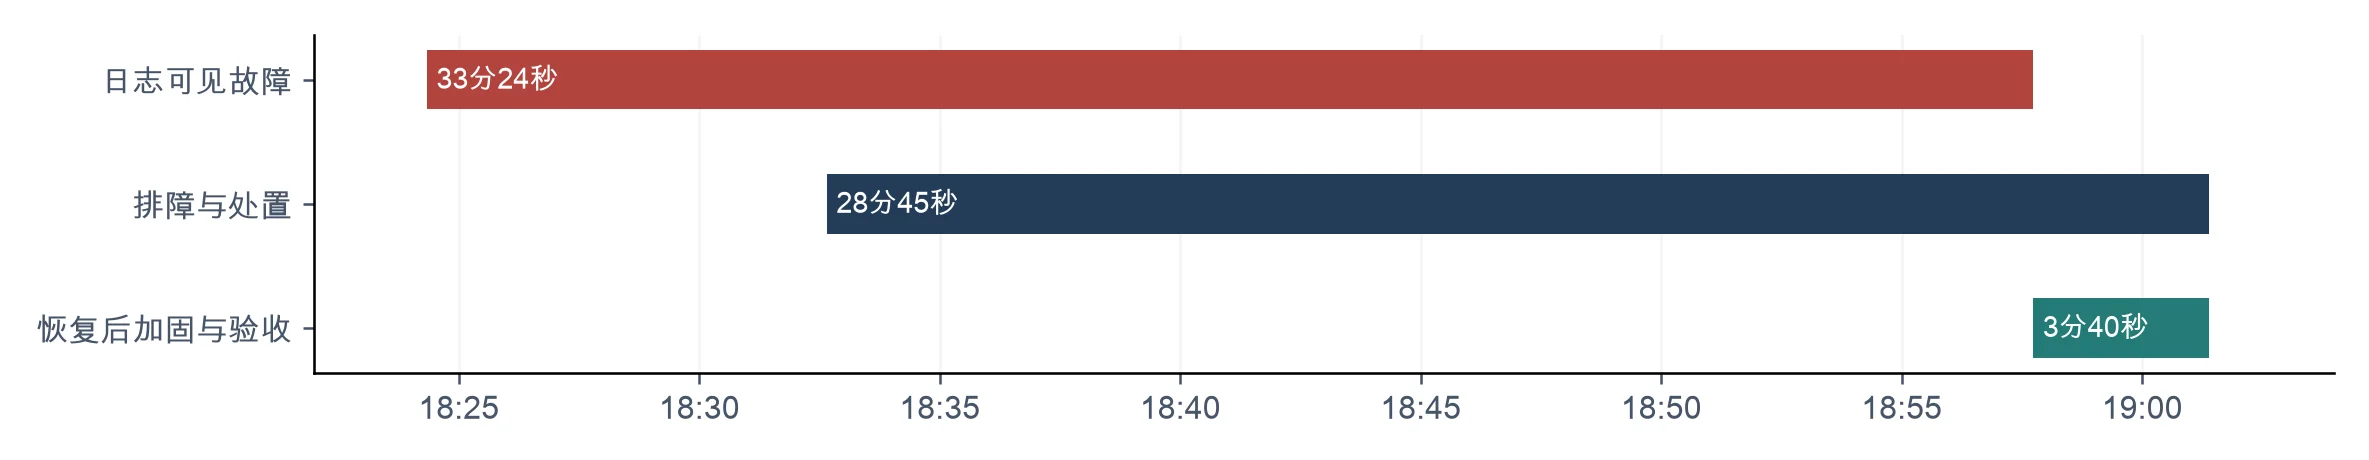
图2 故障、排障和恢复后加固的时间范围。排障历时包含连接等待、取证与决策时间,不等于纯人工操作工时。
| 指标 |
区间与结果 |
| 日志可见故障窗口 |
18:24:20 至 18:57:44,33分24秒 |
| 报告至首次响应 |
18:30:57 至 18:32:39,1分42秒 |
| 报告至首页恢复 |
18:30:57 至 18:57:44,26分47秒 |
| 排障与处置总历时 |
18:32:39 至 19:01:24,28分45秒 |
| 报告至处置完成 |
18:30:57 至 19:01:24,30分27秒 |
| 恢复后加固与验收 |
18:57:44 至 19:01:24,3分40秒 |
| 时间 |
事件及判断价值 |
| 18:23:20 |
故障前最后一条首页200;至恢复的首页成功响应间隔为34分24秒,不能直接等同精确故障时长。 |
| 18:24:20 |
生产首条504;同分钟错误日志出现 upstream timed out。 |
| 18:30:57 / 18:32:39 |
用户报告异常;开始明确响应与排查。 |
| 18:35:07 |
公网 /health 实测约63秒返回504,确认可复现。 |
| 18:40:39 / 18:44:24 |
本机私钥访问权限恢复;SSH回显负载25.28及多进程D状态。 |
| 18:48:37 / 18:49:03 |
vmstat证实95% I/O等待;用户选择暂不重启、继续取证。 |
| 18:53:23 至 18:56:42 |
定位swappiness与预读参数,取得持续文件页重新加载及配置来源证据。 |
| 18:57:19 / 18:57:44 |
系统新一轮启动时间;生产首页恢复200。重启由用户执行。 |
| 18:58:48 / 18:59:58 |
运行参数调整回显成功;创建备份并保存持久化配置。 |
| 19:00:23 至 19:01:24 |
公网及容器验收通过,完成20秒采样与处置交付。 |
诊断依据与因果判断
已证实的现场事实
| 证据 |
现场结果 |
支持的判断 |
| 网络与入口 |
DNS指向 [已脱敏] (正确地址);IP默认页200;TLS握手可完成;业务健康接口504。 |
入口仍可处理部分请求,异常集中在上游服务和主机执行。 |
| CPU与等待队列 |
vmstat连续采样wa=95%;21至26个进程阻塞;读取约137至145 MiB/s。 |
高负载主要来自I/O等待,不能按CPU计算饱和处理。 |
| 阻塞位置 |
PostgreSQL、OpenResty、journal等等待于blk_mq_get_tag;另有文件页等待。 |
多个服务争用块设备请求队列,故障具有主机级影响。 |
| 文件页回收 |
5.32秒样本:文件页重新加载约28,995页/秒,回收约29,539页/秒,扫描约391,170页/秒。 |
已回收的文件页很快被再次访问,存在持续缓存抖动。 |
| I/O来源 |
两个论坛进程、Docker、1Panel、云代理等同时产生读取;部分进程rchar接近0而read_bytes显著增加。 |
大量读取与缺页加载一致,不支持归因为某一个显式文件读取任务。 |
| 内存与参数 |
物理可见内存约1.6 GiB;swap 2 GiB但使用0;swappiness=0;预读8192 KiB。 |
匿名页没有换出,文件缓存承担回收压力;较大预读可能放大读取。 |
当前最有支持的机制
工作集压力上升 → 文件页被持续回收 → 服务再次访问这些页并触发磁盘载入 → 8 MiB预读增加额外读取与缓存占用 → 块设备队列拥塞 → 数据库、反向代理和SSH执行受阻 → 上游超时产生504。swappiness=0限制了正常情况下对匿名页的换出,使现有swap没有分担压力。此参数语义依据 Linux内核文档 [S5]。
结论边界与尚未排除项
高置信结论是I/O饱和及持续文件页重新加载;中高置信解释是内存回收策略与大预读共同放大抖动。最初工作集为何跨过阈值仍未知,应继续核对访问与查询负载、后台任务、缓存增长及云盘限额。不能仅因某进程读取较多就认定其为唯一元凶。
现场抽查的内核日志尾部未见磁盘错误,相关容器memory.events未记录OOM;这些仅降低了相应假设的支持度,不能排除全部历史硬件错误或内存压力。部署时间早于异常约一小时以上,不构成排除代码或延迟任务影响的证据。
恢复操作与配置变更
实际执行记录
重新启动时间18:57:19,首页18:57:44恢复。18:58授权参数调整,执行以下变更。
| 项目 |
原值 |
新值 |
持久化方式 |
| 内存换出倾向 |
swappiness 0 |
60 |
修改 /etc/sysctl.conf;99-sysctl.conf为其符号链接。 |
| 块设备预读 |
8192 KiB |
128 KiB |
新增 /etc/udev/rules.d/99-yourtj-readahead.rules,限定vda的add/change事件。 |
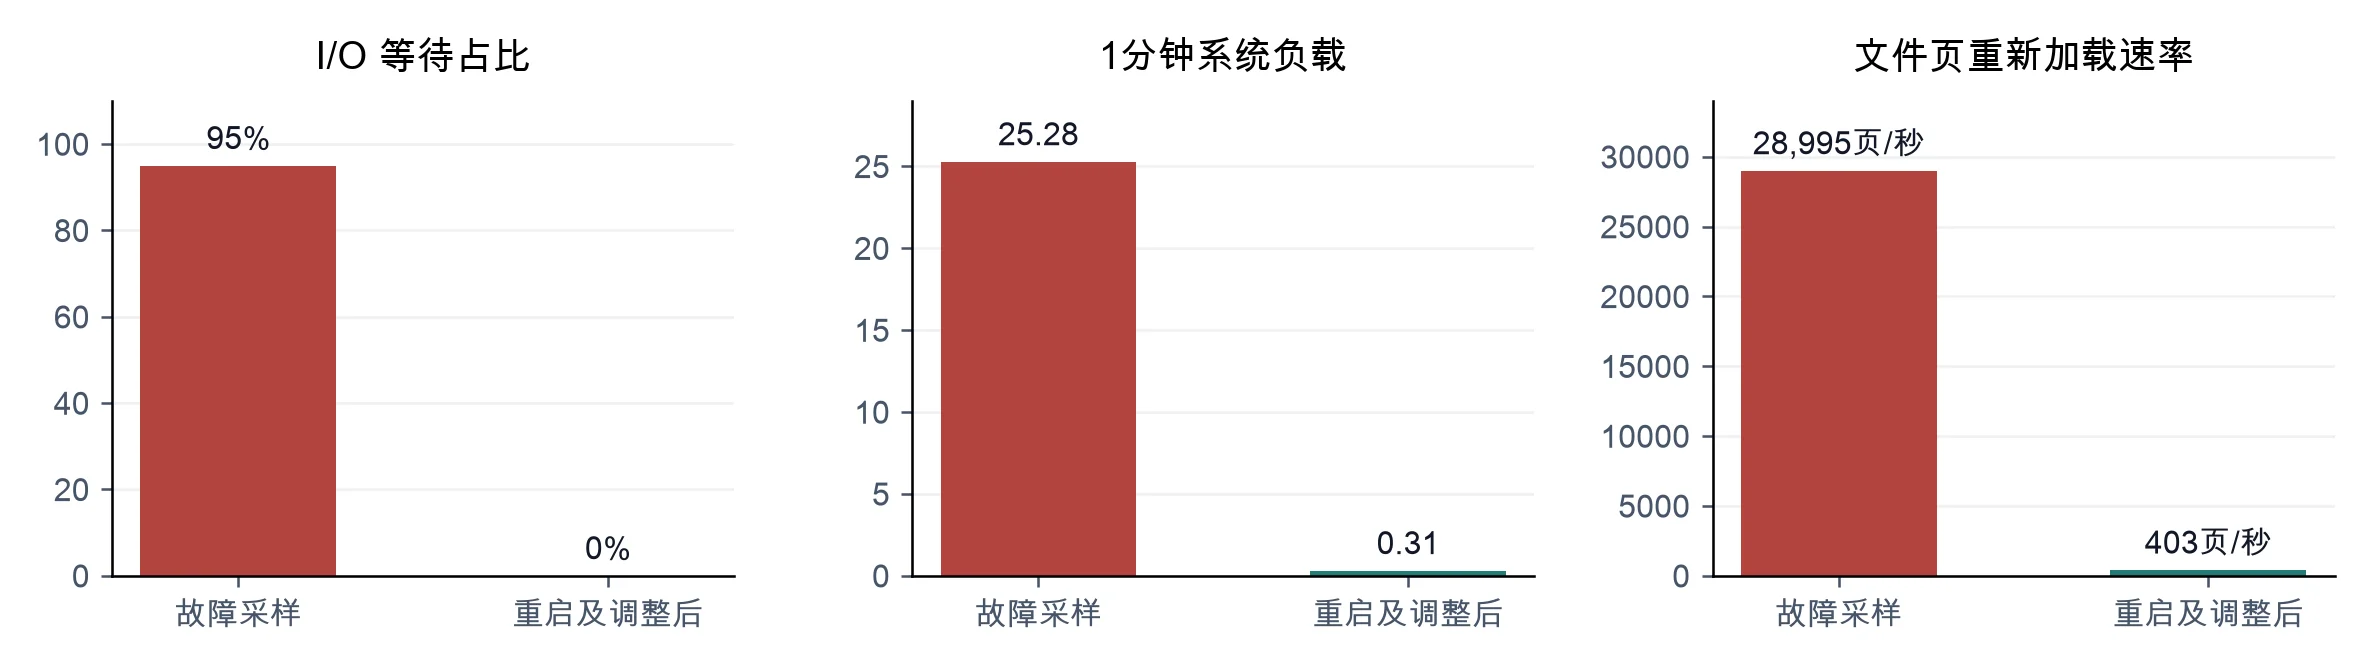
图3 两个独立时点的样本对比。故障值来自18:44至18:56取证,恢复后值来自19:00附近。重启与参数调整均已发生,不能用此图单独估计参数调整的因果效果。
验收结果
生产与测试首页、健康接口全部200,公网响应约0.2至0.5秒;论坛、PostgreSQL、Meilisearch容器均健康。实时vmstat显示I/O等待0%,1分钟负载0.31,swap已使用约70 MiB。20秒样本的文件页重新加载约403页/秒,仍非零,应结合负载持续观察。
已重载udev规则并触发vda change事件;udevadm test确认规则写入128。sysctl配置与运行值均为60。未再次重启验证,因此“已持久化”是配置与规则验证结论,不是第二次启动后的实测。
后续观察与告警建议
本报告不宣称容量永久充足、硬件问题完全排除、参数调整单独治愈故障或所有数据绝对无损。恢复后已有成功响应与短时指标改善,但受控负载对比、完整数据一致性审计和长期压力验证尚未执行。
后续将持续监控并推出更规范全面的日志记录与警报机制。